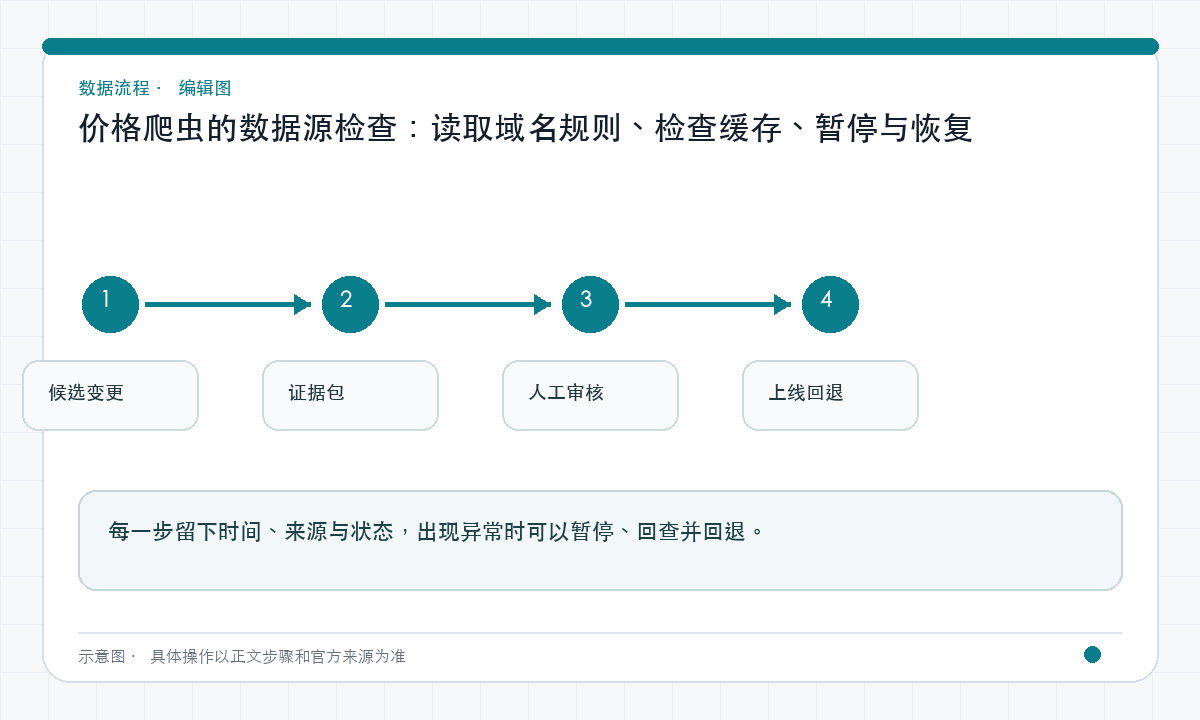
操作速览
- 读取域名规则:按 User-Agent 匹配 robots。
- 检查缓存:规则过期后重新核验。
- 暂停与恢复:规则改变时控制后续抓取。
给一个新价格来源做采集预检
1. 确认页面公开可访问,读取对应主机的 robots.txt,按采集器标识匹配规则并记录时间。
2. 重定向到其他主机时重新核对目标,不把原域名的允许规则套过去。
3. 登录墙、挑战页和来源拒绝应显示采集失败;不要把错误页面解析成零价格或自动换身份继续抓取。
robots 是抓取规则,不是来源背书
RFC 9309 将 robots.txt 定义为服务所有者向自动客户端表达 URI 访问偏好的协议。允许某个路径只表示没有匹配的禁止规则,并不证明页面数据准确、可转载、可商用或属于模型厂商官方来源。
Google 同样强调 robots.txt 用于管理抓取流量,不是隐藏网页或保护秘密的手段。AI 数据源核验要把 crawl_allowed、source_authority 和 content_license 分成不同字段,避免一个绿色 robots 状态掩盖其他风险。
- 允许抓取不等于允许复用
- robots 不承担身份验证
- 敏感页面不应依赖 robots 保护
本节参考:RFC 9309 Robots Exclusion ProtocolGoogle Search Central robots.txt 指南
解析器要实现真正的匹配语义
爬虫应发送可识别的 User-Agent,并用其中的 product token 选择最具体的匹配组;没有专属组时再看星号组。Allow 与 Disallow 路径按最具体匹配决定,等长冲突时 RFC 建议 Allow 优先。
规则比较还涉及大小写、百分号编码和重定向。工程上不要用简单 startsWith 代替标准解析器;至少用测试集覆盖中文路径、查询串、通配符、空规则、多个组和 robots.txt 自身。
- 产品 token 与 HTTP User-Agent 对齐
- 采用最长路径匹配
- 保留原始 robots 文本和解析器版本
本节参考:RFC 9309 Robots Exclusion ProtocolGoogle Search Central robots.txt 指南
把核验结果接到域名启停
每个 AI 价格来源域名应有 enabled、robots_status、checked_at、expires_at、allowed_paths 和 decision_reason。定时重取 robots 后若规则收紧,调度器先暂停受影响路径,再等待人工确认,而不是等下一次抓取失败。
聚合目录链接到多个卡网店铺时,目录域名的规则不能继承到商店域名。子域、协议和端口也需要独立判断;重定向落到新主机时必须重新做 robots 预检,避免白名单通过后跨到未知来源。
- robots 结果有 TTL
- 规则变化触发熔断
- 跨主机重定向重新核验
本节参考:RFC 9309 Robots Exclusion ProtocolGoogle Search Central robots.txt 指南
失败策略与 AI 数据风险
robots.txt 临时不可达、5xx 与网络超时应进入保守重试策略,并限制缓存时间。对于高频 AI 价格任务,宁可显示数据陈旧,也不要在规则状态不明确时自动提高并发。
本文核验截止 2026-08-29,具体来源的 robots 内容可能随时改变。公开页面应显示“最近规则核验时间”和来源状态;若某来源暂停,不应把最后一次价格继续包装成实时,也不应把暂停原因写成对服务商信誉的判断。
- 状态不明时降低抓取
- 陈旧与停用原因分开
- robots 变化不等于服务质量变化
本节参考:RFC 9309 Robots Exclusion ProtocolGoogle Search Central robots.txt 指南
参考来源
价格、规则和产品状态可能变化,可通过这些原始页面确认当前信息。
RFC 9309 Robots Exclusion Protocol
Google Search Central robots.txt 指南
常见问题
AI 价格页没有 robots.txt 就代表随意抓取吗?
不代表。RFC 语义上可能没有适用规则,但仍要检查网站条款、页面性质、负载和数据使用边界,并采用低频可识别请求。
robots.txt 允许目录页,是否也允许目录链接的链动小铺?
不是。每个目标主机都要独立核验;目录站的规则不能自动扩展到被链接的店铺域名。