操作速览
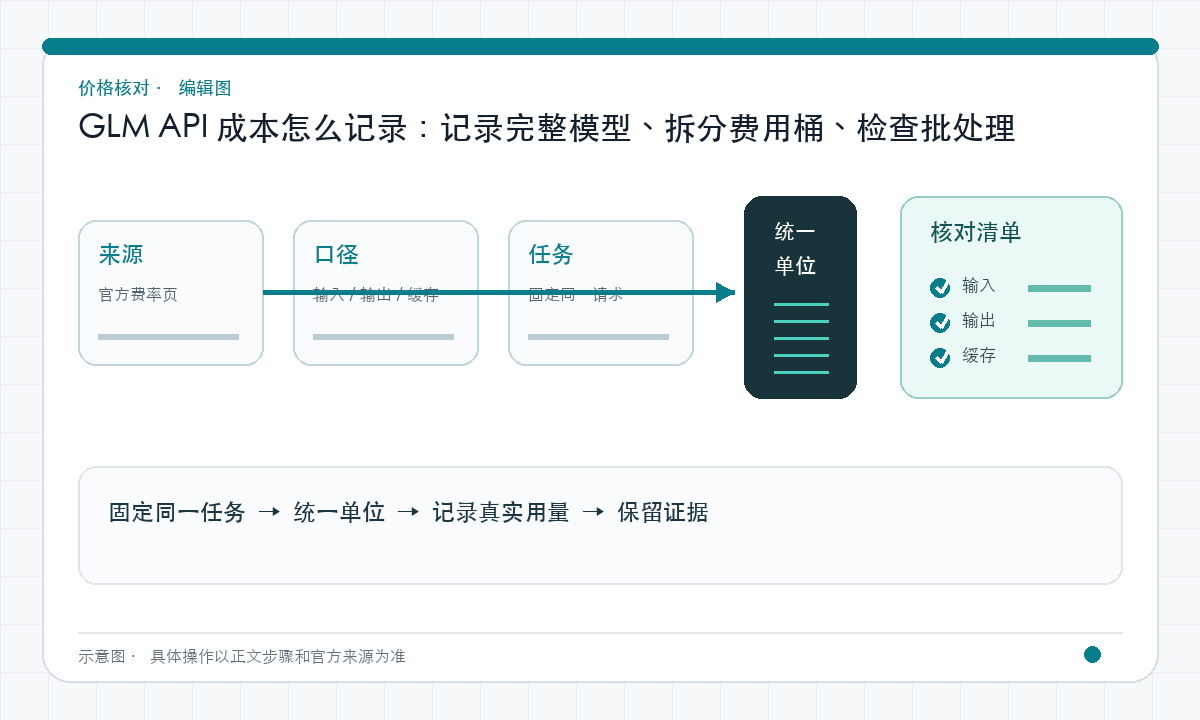
- 记录完整模型:版本、上下文和调用方式。
- 拆分费用桶:输入、输出、缓存分别核对。
- 检查批处理:用任务状态与实际用量对账。
定位 GLM 的实际计价项目
1. 在官方价格页按完整模型名和任务类型查找,区分输入、输出、图片、视频或其他单位。
2. 缓存、批处理和上下文规则逐项查看适用条件。没有明确列出的优惠不自行叠加。
3. 本站自动官方采集目前未覆盖 GLM,本文原始官方链接用于核对;计算器只按你输入的费率计算预算。
先识别价格表中的模型与上下文档位
智谱 BigModel 价格页按 GLM 模型展示上下文、输入、输出、缓存存储和缓存命中等栏目。模型代际与上下文区间会变化,采集时应保存精确 model id、上下文档位和核验日期。
不同计费项可能使用每百万 token、每 token-hour 或按请求等单位。统一账本保留原始单位与货币,再派生每成功任务成本;过早把所有项目塞进一个 token 单价会丢失缓存存储和多模态差异。
本节参考:智谱 BigModel 产品价格智谱 Batch API
Batch 价格要绑定支持列表和队列边界
智谱 Batch FAQ 列出支持模型,并说明 Batch 与标准 API 的价格关系。支持状态是版本化能力,提交前必须从当前文档或接口校验,不能因为同属 GLM 系列就默认全部可用。
官方文档还限制单个 Batch 的请求数、文件大小,并按模型设置最大排队量。分片器应同时检查 bytes、requests 和 queued_requests,给每项写入业务 key 以便结果乱序后回连。
本节参考:智谱 BigModel 产品价格智谱 Batch API
缓存存储与命中是两个成本桶
价格页把缓存存储和缓存命中分列,意味着保存缓存资源与实际读取不能混为一次输入折扣。账本字段至少包含 cache_storage_token_hours、cache_hit_tokens 和 uncached_input_tokens。
只有稳定公共前缀和足够复用次数时缓存才可能回本。对模板 hash 分组计算 token 加权命中率,再把存储时间和冷启动写入成本纳入,避免只展示漂亮的请求命中百分比。
本节参考:智谱 BigModel 产品价格智谱 Batch API
用费率快照和逐项 usage 对账
为每次官方采集生成 price_version,记录 source_url、verified_at、model、tier 和所有单位。请求日志引用 price_version;价格更新后新增版本而不是覆盖旧行,历史账单才能重算。
规则核验于 2026-08-29。Batch 完成后逐项区分成功、永久错误和可重试错误,只重放必要项;最终用实际 usage、缓存状态和 attempt 数计算每个成功结果成本。
本节参考:智谱 BigModel 产品价格智谱 Batch API
参考来源
价格、规则和产品状态可能变化,可通过这些原始页面确认当前信息。
常见问题
GLM Batch API 是否所有模型都支持?
应以智谱当前 Batch 支持列表为准。模型代际和队列限制会更新,提交前需要按精确 model id 校验。
GLM 缓存命中价格包含缓存存储费吗?
价格页将缓存命中与缓存存储作为不同栏目,核算时应分别记录并相加,具体单位与价格以当前官方页为准。