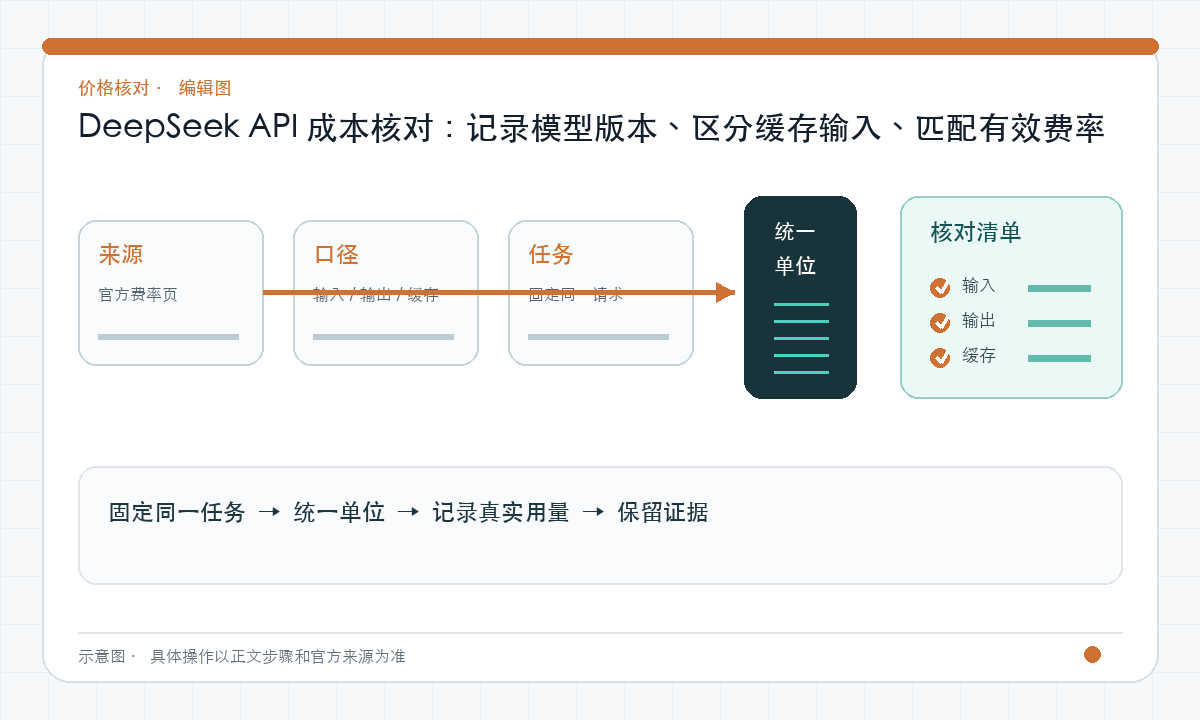
操作速览
- 记录模型版本:完整模型 ID 与采样时间。
- 区分缓存输入:命中与未命中分别对账。
- 匹配有效费率:优惠是否适用以官方为准。
核对 DeepSeek 输入、缓存和时段
1. 打开带完整路径的官方价格页,记录当前模型 ID、输入缓存命中与未命中、输出和时段条件。
2. 不要沿用旧版本截图里的单价。模型升级或时段变化后,对同一任务重新定位费率。
3. 使用响应 usage 与账户账单核对,再通过费用计算器估算。本站的采集时间不等于厂商价格生效时间。
先锁定模型、缓存状态与计费时段
DeepSeek 官方价格页以每百万 token 为展示单位,但核算维度至少包括 model、input cache hit、input cache miss、output 和请求发生的计费时段。任何一项缺失,都可能让同一业务在不同日期或时段看起来成本异常。
扣费公式本质是各类 token 数乘对应费率。工程中应保存费率版本、货币、时区与生效时间,不在文章或代码中写死会变化的金额;本页规则核验日期为 2026-08-29。
本节参考:DeepSeek 模型与价格DeepSeek Token 用量计算
缓存命中与未命中必须分别读取
DeepSeek Context Caching 默认工作,无需为每个请求切换接口。官方 usage 提供 prompt_cache_hit_tokens 与 prompt_cache_miss_tokens,应分别乘命中和未命中费率,再加 completion token 成本。
缓存按前缀匹配,公共材料放在输入前部更容易复用;中间片段相同不等于有效命中。模板 hash、模型、用户隔离键和消息顺序都应进入缓存观测日志。
本节参考:DeepSeek Token 用量计算DeepSeek Context Caching
字符估算只用于预算,响应 usage 才用于结算
官方 token 文档给出的字符换算是近似值,而且不同 tokenizer 与语言分布会改变比例。可在入队前用估算做上下文保护和预算预警,但不要用字符数直接生成财务报表。
批量采样一组中文、英文、代码和结构化数据请求,记录估计 token、实际 hit/miss token 与输出 token。用误差分布设置预算缓冲,比固定乘一个经验系数更稳健。
本节参考:DeepSeek Context CachingDeepSeek 模型与价格
把价格变化、限流与重试纳入同一台账
官方价格页明确提示价格可能调整,因此抓取任务应保存页面核验时间与结构化快照。账单汇总按请求时间匹配费率版本,不能用今天的价格回算昨天的调用。
并发超限可能返回 429;失败重试仍可能增加 token 或延迟成本。重试记录要关联原请求和 attempt,只对暂时错误退避重放,并用每成功任务成本观察重试放大率。
本节参考:DeepSeek 模型与价格DeepSeek Token 用量计算
参考来源
价格、规则和产品状态可能变化,可通过这些原始页面确认当前信息。
常见问题
DeepSeek 缓存需要手动创建吗?
官方文档说明 Context Caching 默认启用;是否命中取决于已持久化前缀和后续请求的前缀匹配,仍需读取 usage 验证。
DeepSeek API 价格可以长期写进配置吗?
应使用带生效时间的费率快照并定期核验官方页。历史请求按当时版本结算,新价格只作用于对应时间段。