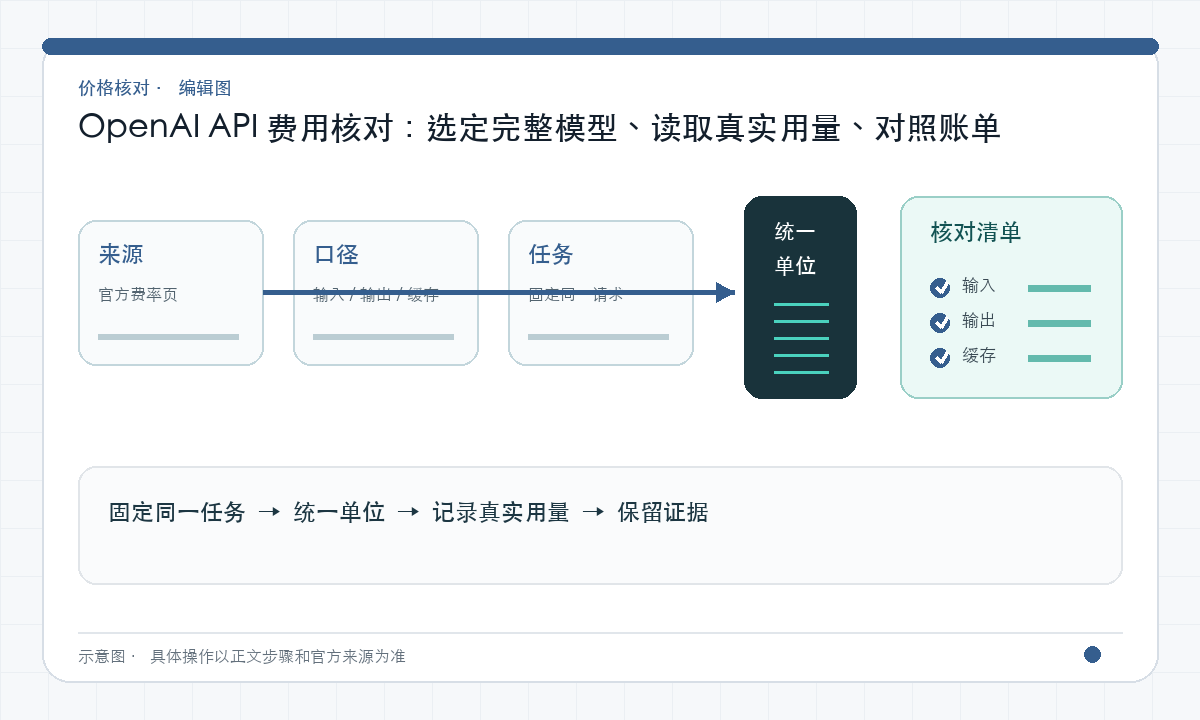
操作速览
- 选定完整模型:版本、处理层与适用条件。
- 读取真实用量:输入、缓存与输出分开。
- 对照账单:额外工具费用独立检查。
用实际请求核对 OpenAI 费用
1. 先记录模型 ID、调用接口和服务层,再从官方价目表定位输入、输出及适用的缓存项目。
2. 把工具调用、存储或其他附加费用列在独立行。正文 tokens 的计算器不包含所有接口开销。
3. 用一小组真实 usage 复算,逐项对照账单;不要把不同模型或地区的缓存规则互相套用。
先把价目表拆成独立价格桶
OpenAI 官方价格页不是一个“每百万 token 单价”,而是按模型、处理层和上下文档位分列输入、缓存输入、缓存写入与输出。成本表至少要保存 provider、model、model snapshot、service tier、context band、currency 和 verified_at,不能只留下一个 blended_price。
工具型请求还可能产生按调用次数、存储量或容器时长计算的费用。建表时把 token_cost、tool_call_cost、storage_cost 和 container_cost 分开;否则某次检索或代码执行增加的费用会被误归因于模型输出 token。
- 价格版本必须带核验日期
- 输入、缓存写入、缓存读取、输出分栏
- 工具与存储费用单列
本节参考:OpenAI API PricingOpenAI Counting tokens
把响应 usage 映射到账本字段
请求前的 token counting 适合做预算上限,请求后的 usage 才适合结算。对 Responses API,可分别记录 input_tokens、input_tokens_details.cached_tokens、input_tokens_details.cache_write_tokens、output_tokens 与 reasoning_tokens,再将普通输入计算为 input_tokens 减去缓存读取和缓存写入。
单次调用成本可写成:普通输入×普通输入价+缓存读取×缓存价+缓存写入×写入价+输出×输出价+工具费用。所有 token 价格统一除以一百万后计算,原始 token 与价格版本同时保留,方便价格变更后重放历史账单。
本节参考:OpenAI Counting tokensOpenAI Prompt caching
上下文档位和处理层不能丢
截至 2026-08-29,OpenAI 价格页对部分模型区分短上下文与长上下文,并提供 Standard、Batch、Flex、Fast 等处理层。相同模型名并不保证相同费率,所以请求日志必须记录实际 service_tier 和触发的上下文档位。
预算模型不要把异步 Batch 的价格套到同步流量,也不要把 Fast 的延迟承诺与 Standard 混成平均价。更稳妥的做法是按业务队列分别预测:实时队列使用标准或快速层,离线队列使用 Batch,再在月度汇总层合并。
本节参考:OpenAI Prompt cachingOpenAI API Pricing
用样本对账和价格快照维持准确性
每天抽取一组成功请求,把本地公式结果与平台 usage、项目用量和账单导出对齐。差异应归因到 token 估计误差、工具费用、区域处理、长上下文、重试或价格版本,而不是直接修改一个“修正系数”掩盖来源。
价格抓取应生成新版本而不是覆盖旧记录。页面展示当前费率时标注核验日,成本复盘则按调用发生时的价格版本计算;这样既避免把今天的价格写回历史,也能在厂商调价后快速定位预算偏差。
本节参考:OpenAI API PricingOpenAI Counting tokens
参考来源
价格、规则和产品状态可能变化,可通过这些原始页面确认当前信息。
常见问题
OpenAI API 成本能只用输入 token 加输出 token 计算吗?
不建议。还应区分缓存读取、缓存写入、上下文档位、处理层和可能的工具或存储费用,并按核验日期绑定价格版本。
请求前的 token counting 能代替最终账单吗?
它适合预算与路由;最终结算应使用响应 usage 和平台账单,因为实际输出、缓存命中及工具调用只有运行后才完整。