操作速览
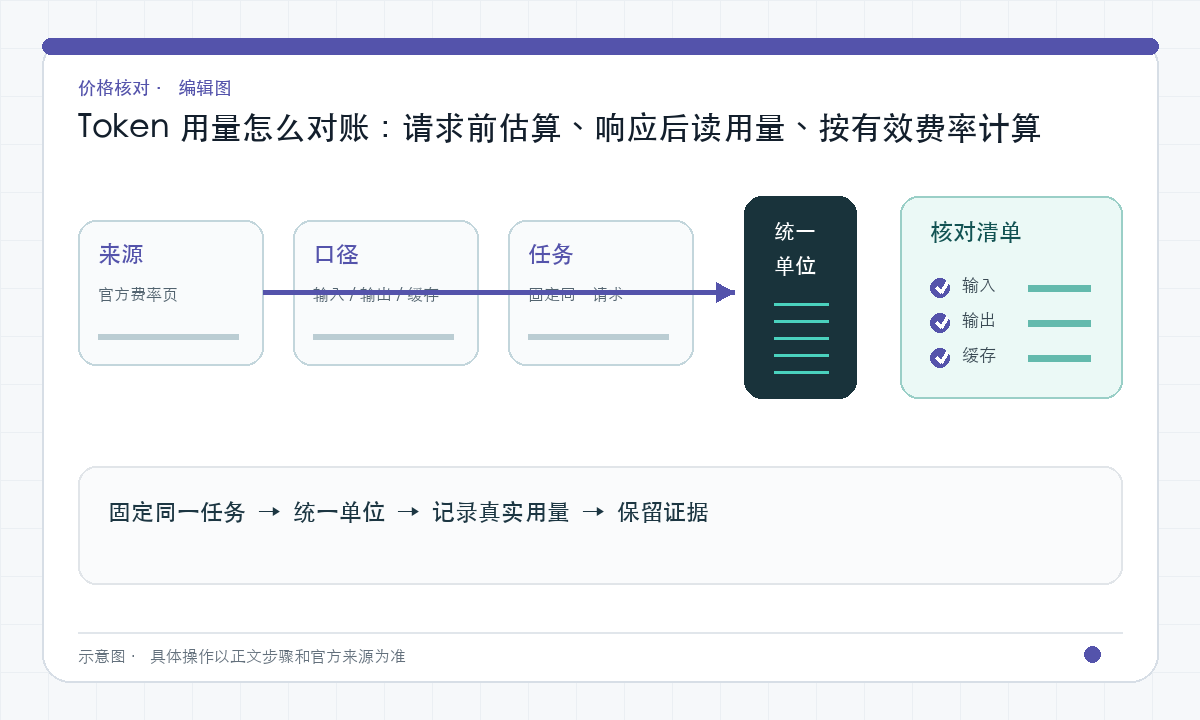
- 请求前估算:用于预算,不代表最终账单。
- 响应后读用量:保留输入、输出和缓存字段。
- 按有效费率计算:统一单位并记录采样时间。
从文本预估走到真实账单
1. 先使用对应编码的 tokenizer 计算正文,再把系统提示、历史对话和工具定义等额外输入考虑进去。
2. 收到响应后保存厂商原始 usage;缓存命中、输出和其他计费项目单独归类。
3. 本站计算器支持指定编码的文本计数与手填费率预算,不能替代 Claude、Gemini 或其他模型的官方计数接口。
请求前计数与请求后计量承担不同职责
三家厂商都提供请求前 token 计数能力,但结果应用于预算、上下文检查和模型路由,而非最终账单。Claude 官方还提醒计数是估计值,实际 Messages 输入可能有小幅差异;因此 estimate_tokens 与 billed_usage 必须分列。
请求后保存原始 usage JSON,并提取 provider、model、input、cache read、cache write、output、thinking/reasoning 和 total。任何无法映射的新增字段先进入 provider_extra,不应静默并入 input。
本节参考:OpenAI Counting tokensClaude Token counting
建立语义映射而不是字段名映射
OpenAI 的 cached_tokens 与 cache_write_tokens、Claude 的 cache_read_input_tokens 与 cache_creation_input_tokens、Gemini 的 cached_content_token_count 描述相近但规则不同。统一账本可使用 cached_read_tokens 和 cache_write_tokens,但必须保留 provider_semantics 与原字段。
Gemini 还会暴露 thoughts_token_count,OpenAI reasoning 模型有 reasoning_tokens;这些字段在厂商价格口径中可能计入输出相关费用。统一层应叫 hidden_or_thinking_output_tokens,并通过每家价格规则决定是否单独计价,不能假设三家完全相同。
本节参考:Claude Token countingGemini token counting
统一计价单位,同时保留模态差异
展示层可以统一到每百万 token,但底层必须保留原始计价单位、币种、模态和上下文档位。文本、图片、音频、视频或文档可能采用不同 token 化与价格规则,相同 token 数并不意味着相同信息量或成本。
跨厂商比较应以同一业务样本为基准:固定输入文件、目标输出 schema、质量阈值和最大重试次数,分别调用各模型并记录实际 usage。最终比较每个合格任务成本,而不是只把价格页上的每百万 token 数字排成一列。
本节参考:Gemini token countingOpenAI Counting tokens
用估算误差和任务成本做双重校准
对每个 provider 计算 estimate_error=实际输入 token-请求前估计 token,并按模型、语言、工具和模态分组。误差持续扩大通常意味着 tokenizer、请求渲染或工具定义发生变化,需要重新基线,而不是继续沿用旧换算比例。
同时计算 cost_per_successful_task=所有尝试总成本÷合格结果数,并保留 latency 与 quality。这样可以识别一种常见情况:单 token 更便宜的模型因为输出更长或重试更多,最终每任务成本反而更高。
本节参考:OpenAI Counting tokensClaude Token counting
参考来源
价格、规则和产品状态可能变化,可通过这些原始页面确认当前信息。
常见问题
不同大模型的一个 token 可以直接视为等量文本吗?
不建议。tokenizer、语言、模态和请求渲染规则不同,应使用同一业务样本获取各厂商实际 usage,再比较每个合格任务成本。
为什么要同时保存原始 usage JSON 和统一字段?
统一字段便于比较,原始 JSON 则保留厂商语义和未来新增字段,避免映射规则变更后无法重算历史成本。