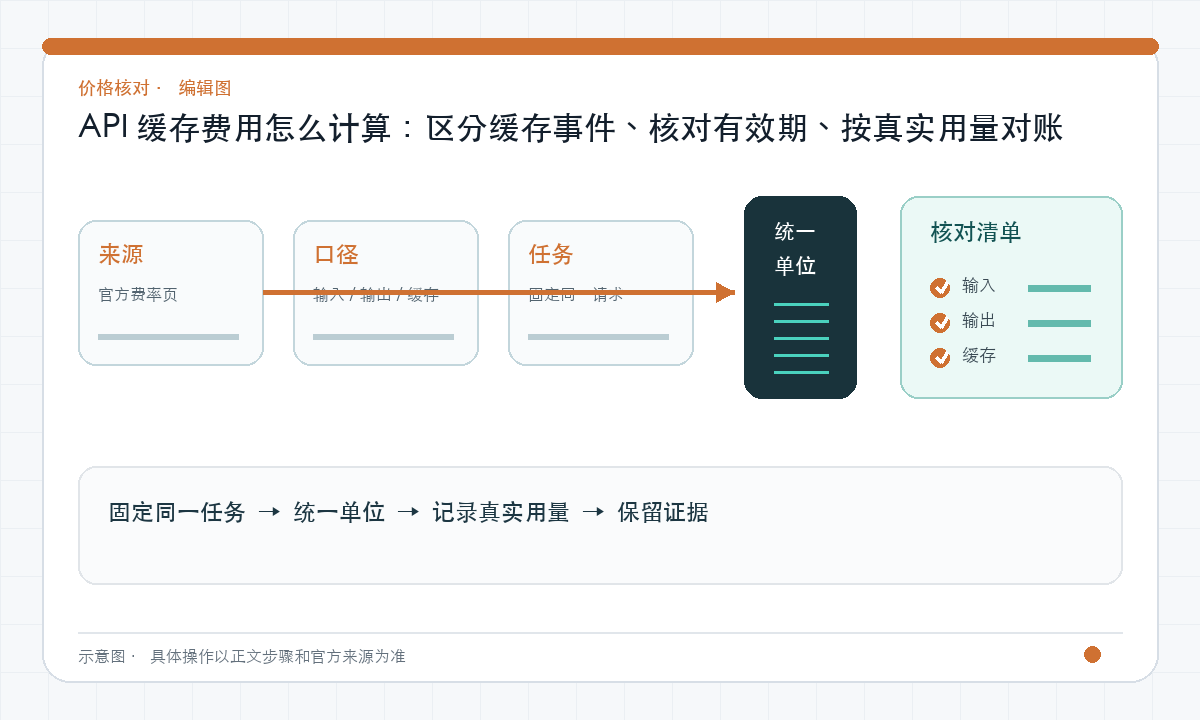
操作速览
- 区分缓存事件:写入、读取和未命中。
- 核对有效期:TTL 与存储收费条件。
- 按真实用量对账:不能把全部输入都算命中。
先验证命中,再计算缓存收益
1. 准备一组重复前缀的请求,记录缓存创建、读取与未命中用量,不以开关已开启作为命中证据。
2. 加入写入溢价、存储时长和失效后重建成本,再与无缓存条件下的同一任务比较。
3. 请求顺序、前缀变化与实际版本都会影响结果。保留模型、规则日期和样本,收益只能解释这组条件。
先把缓存拆成四个可计量成本桶
跨厂商比较缓存时,至少需要记录普通输入、缓存创建或写入、缓存读取或命中、缓存存储四个桶。某家没有独立存储费时该项为零,而不是从账本删除;这样同一公式才能覆盖 Prompt Caching 与 Context Caching。
建议使用 C = U×Rᵤ + W×R𝓌 + H×Rₕ + S×T×Rₛ,其中 U、W、H 是 token 数,S×T 是 token-hours。费率必须绑定模型、地区、处理层和核验日期,正文不复制会变化的货币单价。
- 普通输入 U
- 写入 W
- 命中 H
- 存储 S×T
本节参考:OpenAI Prompt cachingClaude Prompt caching
命中由前缀稳定性决定,不由开关决定
OpenAI 与 Claude 的缓存都强调稳定前缀:系统说明、工具定义和长公共材料应放在前面,把用户变量放在后面。前缀任何早期变化都会扩大未命中范围,因此命中率要按模板版本和调用类型分组观察。
Gemini 还需要区分隐式命中与显式缓存资源。显式缓存有 TTL 和存储周期,隐式缓存更省操作但不保证命中;二者都应以响应 usage 为准,而不是把“已启用缓存”直接当作节省。
本节参考:Claude Prompt cachingGemini Context caching
用回本次数和有效命中率做决策
一次缓存写入是否值得,取决于写入溢价、命中读取费率、预计复用次数与 TTL 内的请求分布。可用 N_break-even = 写入增量成本 ÷ 单次命中节省额估算门槛,再用历史有效命中率修正,而不是用理论最大复用次数。
对 Gemini 显式缓存还要加入 token-hours;对 Claude 要区分不同 TTL 的写入倍率;对 OpenAI 要核对 usage 中缓存相关 token。规则核验于 2026-08-29,实际倍率和支持模型应在部署前重新读取官方页。
本节参考:Gemini Context cachingOpenAI Prompt caching
把缓存观测接入成本与容量看板
每次调用记录 template_hash、model、uncached_tokens、cache_write_tokens、cache_read_tokens、storage_token_hours 与 total_cost。命中率应同时展示 token 加权值和请求加权值,避免大量短请求掩盖少数长上下文未命中。
缓存也会改变限流容量:部分厂商对缓存读取 token 的限流处理不同,Batch 与缓存的价格修饰项也不一定以相同方式叠加。成本优化上线前应分别验证计费账单和 429 行为,并为前缀变更准备冷启动预算。
本节参考:OpenAI Prompt cachingClaude Prompt caching
参考来源
价格、规则和产品状态可能变化,可通过这些原始页面确认当前信息。
常见问题
大模型 API 开启缓存后一定更便宜吗?
不一定。低复用、频繁改前缀、TTL 过长或显式存储闲置都可能让写入与存储成本超过命中节省,应以实际 usage 和回本次数判断。
三家 AI API 的缓存命中率可以直接比较吗?
先统一为 token 加权命中率,并保留各家的写入、读取、存储和限流语义。只比较请求命中次数会丢失上下文长度差异。