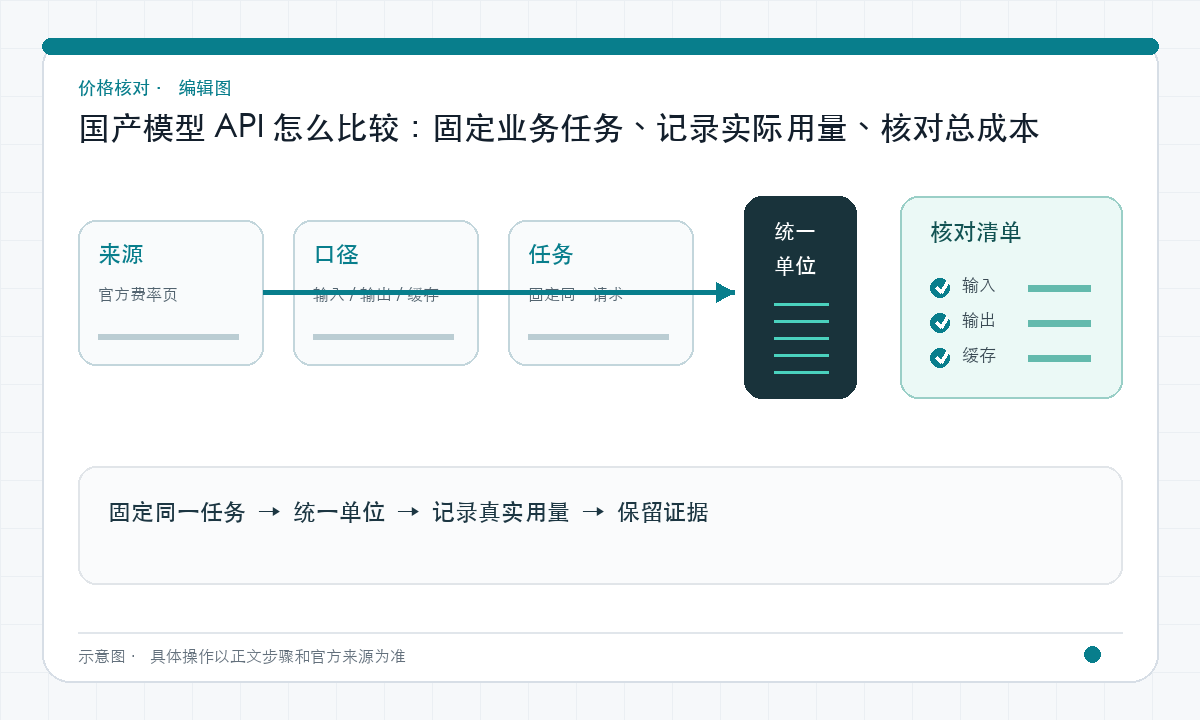
操作速览
- 固定业务任务:先定义质量与验收条件。
- 记录实际用量:同条件下观察速度与失败。
- 核对总成本:结合费用、质量和重试次数。
比较国产模型时固定一组任务
1. 为 DeepSeek、GLM、Kimi 等候选准备相同任务和质量门槛,但分别记录它们自己的实际 tokens 与费用。
2. 文字、图像、缓存、联网搜索和 Batch 分开计价;不存在统一适用于所有厂商的最低综合价。
3. 当前自动采集覆盖 DeepSeek、千问与 MiniMax 等来源,未覆盖厂商使用本文官方链接核价,不虚构自动监控状态。
先按任务选模型候选
把任务分成文本整理、代码、长文档、检索或多模态等类型,明确需要的输入格式与验收结果。DeepSeek、GLM、Kimi、千问等产品应按具体模型版本比较,不能用品牌名称代表全部能力。
账户地区、支付、部署和数据处理条件分别查看厂商文档。不能仅根据“国产”标签就推断所有数据一定保留在某个位置,或所有模型都适合你的中文任务。
价格表必须保留单位
分别记录输入、输出、缓存创建与读取、图片或其他项目。币种、单位、上下文、服务层和优惠期一致时,价格才有可比性。
模型版本与计价条件可能变化。本站当前自动采集部分官方来源;GLM、Kimi 等尚未自动覆盖的项目,应从本文列出的官方页面核对,不能视为已实时同步。
中文 tokens 用实际数据核对
同一段中文在不同 tokenizer 下可能得到不同用量。不要用固定“一个 token 等于几个汉字”的比例结算;请求前使用对应计数方法,请求后保存真实 usage。
本站计算器提供指定 OpenAI 编码的正文计数,也支持直接填写真实 tokens 估算费用。它不冒充所有国产模型的官方 tokenizer。
优惠要与适用条件一起计算
缓存、Batch、时段和活动可能改变费用,但不一定能叠加。先确认所选模型支持哪些方式,再计算一组符合条件的任务。
需要实时返回的任务不能仅因批处理价格低就改成无法满足时延的方式。费用比较应同时考虑完成时间和通过验收的结果数。
用同一份测试集作出选择
准备典型、复杂、信息缺失和错误输入等样本,给每条写出质量门槛。分别记录实际费用、响应时间、失败和人工修改,保留日期与配置。
最终采用能够满足任务要求的方案,并安排模型或价格变化后的复核。本文提供可重做的比较方法,不给未经同条件测试的品牌作永久排名。