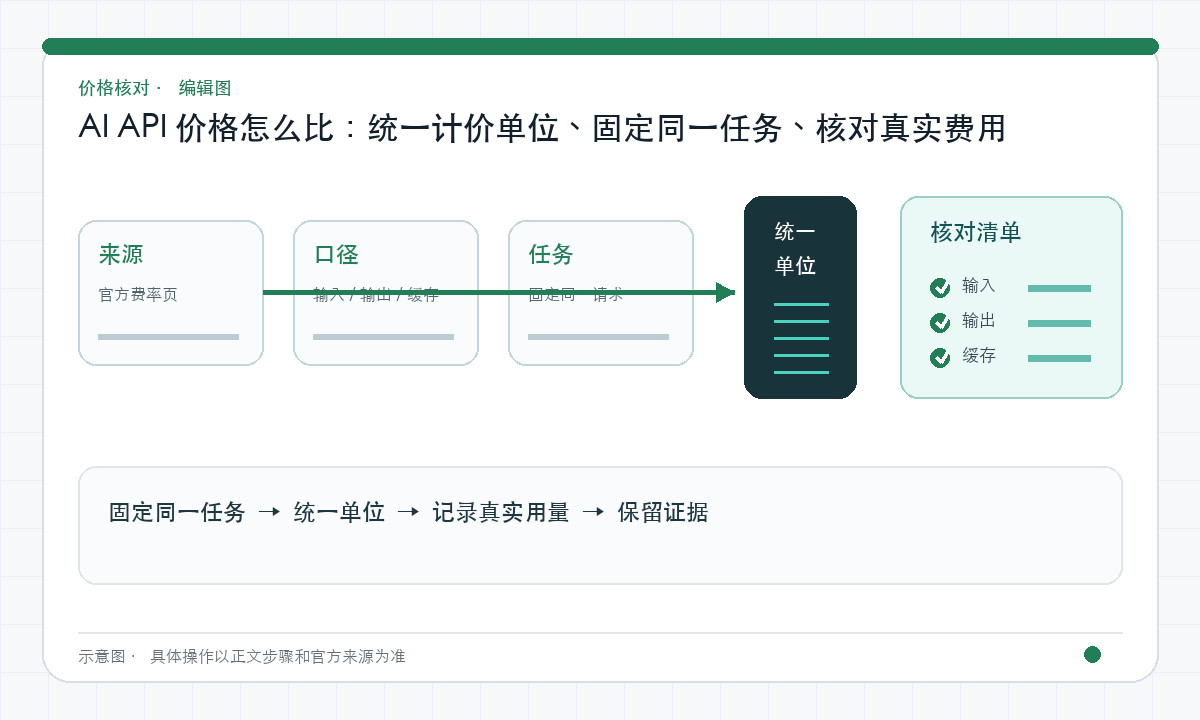
AI API 价格比较真正要回答的是“完成同一个合格任务要花多少”,而不是哪家每百万 token 的数字更小。先把输入、输出、缓存、工具调用和重试分桶,再用同一任务的真实 usage 与官方费率重算。
先看结论:比较合格任务成本
如果只比较每百万 token 单价,容易把 tokenizer、缓存命中、工具费和失败重试漏掉。更可靠的做法是固定一个业务任务,记录每次尝试的原始 usage,再用核验日有效费率重算;最后只把通过验收的任务算进分母。
- 先固定任务、输出格式和质量门槛。
- 再分别记录普通输入、缓存、输出、工具和重试。
- 最后用“全部尝试成本 ÷ 合格任务数”做决策。
操作速览
- 统一计价单位:输入、输出和缓存分开记录。
- 固定同一任务:模型、上下文与重试条件一致。
- 核对真实费用:用量乘费率,再检查工具费用。
用同一任务做可复算的价格比较
1. 先固定输入、输出要求和质量门槛,再分别记录各模型的实际用量,不假定相同文本有相同 token 数。
2. 将普通输入、缓存、输出、工具与重试分别乘适用费率,汇总全部尝试成本。
3. 用总成本除以通过验收的唯一任务数;同时看耗时与失败,避免低单价掩盖更多重试和返工。
先定义能容纳三家差异的账本
统一成本记录至少包含 provider、model、snapshot、endpoint、region、service tier、context band、modality、currency 和 price_version。用这些维度定位价格表,再分别记录 ordinary input、cache read、cache write、output、thinking/reasoning、tool calls、storage 与 retries。
统一不是抹平差异。Claude 缓存有写入与读取乘数,Gemini 显式缓存还涉及 token-hours 存储,OpenAI 处理层和上下文档位可能改变费率;账本为每个厂商保留 rule_id 与原始 usage,统一层只负责汇总。
本节参考:OpenAI API PricingClaude API Pricing
比较同一任务,不比较抽象 token
不同 tokenizer、系统渲染、工具 schema 和 thinking 机制会让同一文本产生不同 token。测试集必须固定输入、输出 schema、质量判定、工具集合和截止时间,分别记录实际 usage、延迟、重试与通过率。
核心指标是 cost_per_accepted_task=全部尝试成本÷通过验收的唯一任务数。辅以 P50/P95 延迟、质量得分和失败率,才能判断低单价是否被更长输出、更多重试或更低通过率抵消。
本节参考:Claude API PricingGemini Developer API pricing
把所有修饰项放进可重算公式
通用公式可表示为 token buckets×对应费率+cache storage+tool usage+retry attempts。Batch、地区或服务层不是一个全局折扣开关,而是价格查找条件或分桶乘数;每个厂商按官方规则实现独立 calculator。
页面展示不应写死会变化的模型美元值,可展示公式、价格核验日期和跳转官方页。后台保存当日价格快照,定期运行同一基准样本并生成差异,避免模型别名、促销或地区规则变化后继续输出旧结论。
本节参考:Gemini Developer API pricingOpenAI API Pricing
最终输出决策表而非价格排行榜
决策表按实时交互、可等待离线、重复长前缀、长上下文、多模态和工具调用等工作负载分组。每组展示适用模型候选、任务成本区间、延迟、质量门槛、主要成本驱动和数据核验日。
结论使用“在本样本与本日期下”限定,不把某次基准写成永久排名。采购或路由策略还应设置重新核验触发器:价格页更新、模型快照变化、缓存命中率明显变化或重试率越过阈值。
本节参考:OpenAI API PricingClaude API Pricing
参考来源
价格、规则和产品状态可能变化,可通过这些原始页面确认当前信息。
常见问题
为什么不能直接比较三家每百万 token 单价?
tokenizer、缓存规则、上下文、服务层、thinking、工具费用和任务通过率不同。应在同一业务样本上比较每个合格任务的总成本。
跨厂商成本表多久更新一次?
至少在价格页、模型快照或计费规则变化时重建快照;生产中还应定期重跑基准,并为所有结论标注核验日期。